Виявлення, сканування та індексація — різні етапи
Спочатку Google має дізнатися про URL через внутрішнє посилання, sitemap або зовнішнє джерело. Потім робот може просканувати сторінку й отримати її HTML. Лише після обробки Google вирішує, чи додавати сторінку до індексу та яку URL вважати канонічною.
Тому повідомлення «невідома Google URL-адреса» відрізняється від «проскановано — наразі не проіндексовано». У першому випадку проблема часто у виявленні, у другому Google уже бачив сторінку, але не включив її до індексу або ще не завершив обробку.
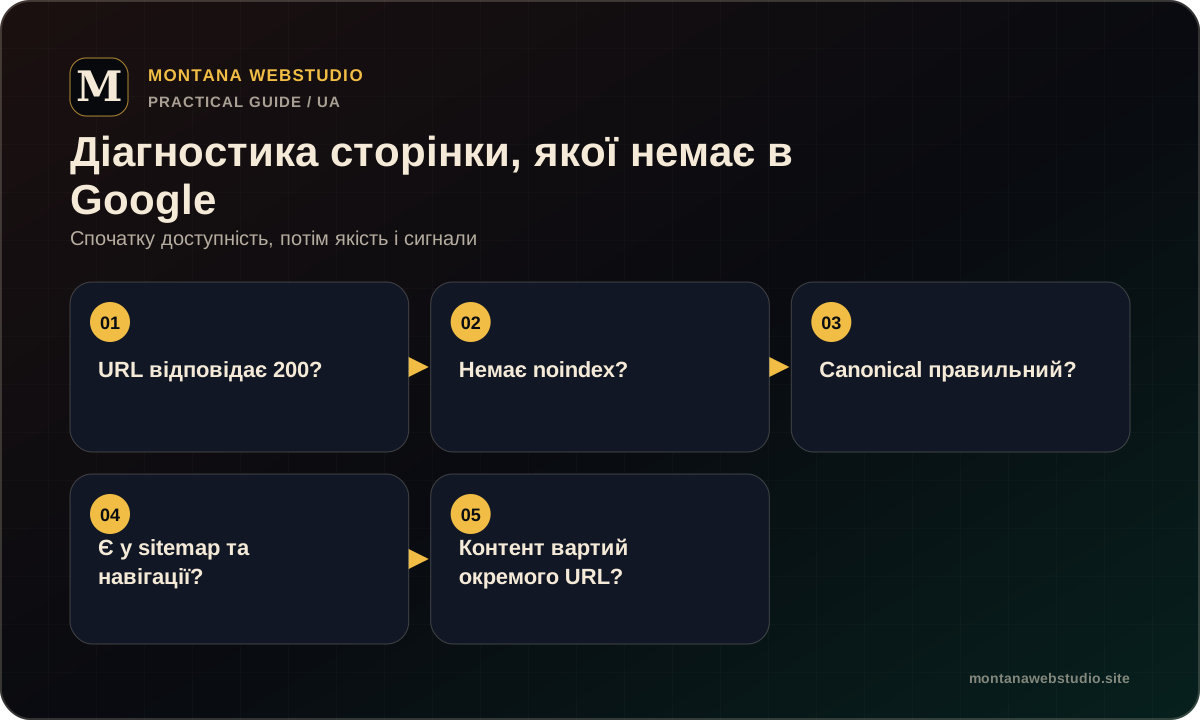
Перевірте технічні блокування
Відкрийте URL без авторизації та перевірте статус відповіді. Сторінка не повинна повертати 404, 5xx або нескінченний редирект. У коді й HTTP-заголовках не має бути noindex, якщо сторінка призначена для пошуку.
Robots.txt не повинен закривати потрібний шлях. Якщо сканування заборонено, Google може знати URL, але не прочитати вміст. Також перевірте, чи canonical не вказує на іншу сторінку: у такому разі пошукова система може свідомо не індексувати поточний дубль.
- HTTP-статус 200 для сторінки, яку треба індексувати.
- Немає meta robots noindex або X-Robots-Tag: noindex.
- Robots.txt дозволяє сканування CSS, JavaScript і сторінки.
- Canonical веде на правильну канонічну версію.
- Сторінка не залежить від дії, яку Googlebot не може виконати.
Допоможіть Google знайти сторінку
Додайте канонічний URL у sitemap і переконайтеся, що файл доступний. Але не покладайтеся лише на sitemap: сторінка повинна мати природні внутрішні посилання з релевантних розділів. URL, на який не посилається жодна сторінка, виглядає ізольованим і незручним для користувача.
Внутрішній анкор має пояснювати, що людина знайде після переходу. Посилання «докладніше» менш інформативне, ніж «технічний SEO-чекліст», якщо саме цей матеріал відкривається.
Оцініть унікальність і користь сторінки
Технічно доступна сторінка не обов’язково потрапить до індексу. Якщо вона майже повторює іншу URL, має кілька загальних речень, виглядає як службовий фільтр або створена лише під варіацію ключового слова, Google може не бачити окремої цінності.
Порівняйте сторінку з уже індексованими матеріалами сайту. Вона повинна відповідати на окремий намір, мати зрозумілий H1, достатній контекст, власні приклади або практичну структуру й вести користувача далі. Об’єднати слабкі дублікати часто краще, ніж домагатися індексації кожного.
Як перевіряти URL у Search Console
Інструмент перевірки URL показує, чи відомий Google адрес, чи дозволене сканування та індексація, який canonical заявив власник і який обрав Google. Після виправлення скористайтеся перевіркою опублікованої версії, а потім запитом на індексацію для пріоритетної сторінки.
Не надсилайте один URL щодня. Якщо технічні умови й контент не змінилися, повторний запит не вирішить першопричину. Для нового сайту нормальна затримка між публікацією, скануванням і появою в результатах. Повний список стартових перевірок є в матеріалі про технічне SEO перед запуском.
| Статус | Що означає | Перший крок |
|---|---|---|
| URL невідома Google | Адресу ще не виявлено | Внутрішнє посилання й sitemap |
| Заблоковано robots.txt | Сканування заборонено | Перевірити правило для шляху |
| Альтернативна сторінка з canonical | Google бачить іншу основну URL | Перевірити дублікати й сигнали |
| Проскановано, не проіндексовано | Сторінку оброблено без включення | Оцінити якість, дублювання й контекст |
| URL є в Google | Сторінка в індексі | Аналізувати покази та запити |
Часті запитання
Скільки чекати індексацію нової сторінки?
Фіксованого строку немає. На новому або рідко оновлюваному сайті виявлення й обробка можуть тривати довше, ніж на ресурсі, який регулярно сканується.
Чи потрібно подавати кожну сторінку вручну?
Ні. Нормальна структура внутрішніх посилань і sitemap дозволяють Google знаходити сторінки автоматично. Ручна перевірка корисна для пріоритетних URL і діагностики.