robots.txt керує доступом пошукових роботів
Файл robots.txt лежить у корені хоста й повідомляє crawler, які шляхи він може або не може запитувати. Його основна роль — керування скануванням, а не приховування інформації від людей або гарантоване видалення URL із результатів пошуку.
Сторінка, заблокована через Disallow, іноді все одно може бути відома пошуковику з зовнішніх посилань. Оскільки пошуковий робот не завантажить HTML, він також не побачить meta noindex усередині заблокованої сторінки.
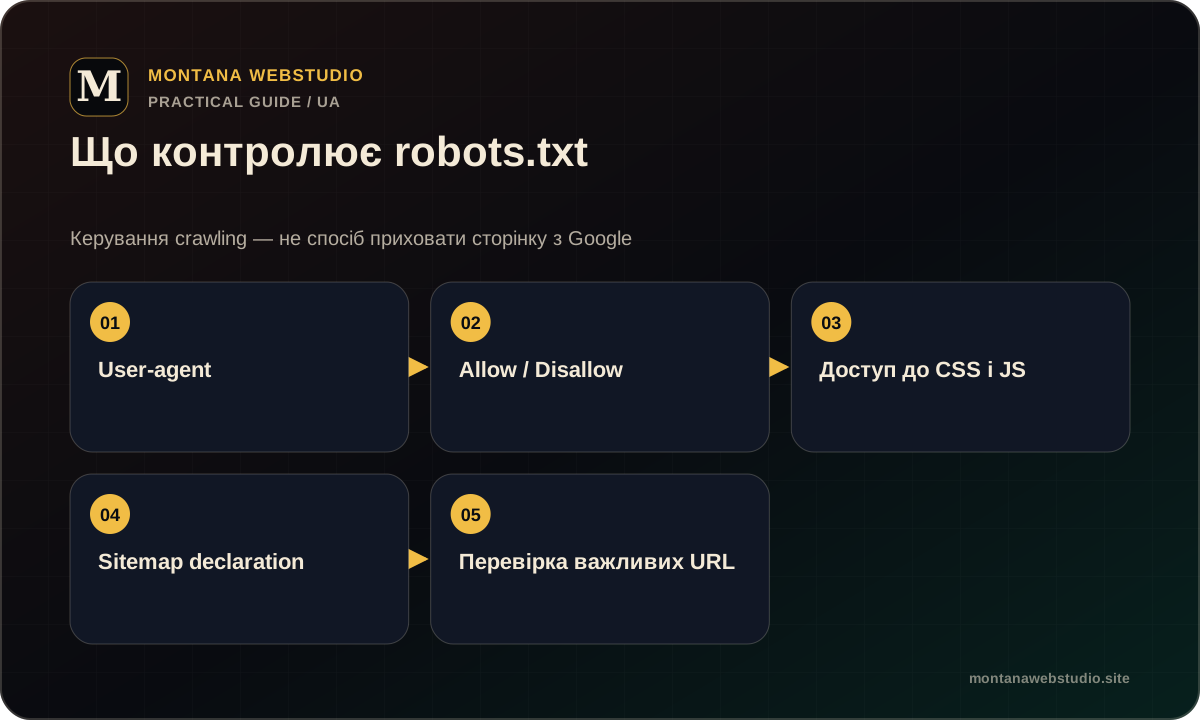
Починайте з фактичного production-файлу
Відкрийте /robots.txt на потрібному протоколі й хості. Перевірте HTTP-статус, Content-Type і те, куди веде HTTP або www-версія. Копія з репозиторію не доводить, що сервер віддає той самий файл.
Правила застосовуються до конкретного хоста. Якщо сайт використовує піддомени, кожен із них може мати власний robots.txt. Коментарі допомагають людям, але не повинні змінювати логіку груп.
- HTTPS-адреса повертає 200.
- Файл доступний без входу й додаткової перевірки.
- Sitemap вказує на актуальний HTTPS URL.
- Немає випадкового Disallow: /.
Як працюють User-agent і правила
Група починається з одного або кількох рядків User-agent, після яких ідуть Allow та Disallow. Порожній Disallow не блокує сайт, а слеш після нього може заблокувати весь хост для відповідної групи.
Перевіряйте довші й коротші шляхи на реальних URL. Правило для /admin/ не повинно випадково перекривати публічний ресурс зі схожим префіксом. Параметри й регістр також мають значення залежно від адреси.
| Рядок | Що означає |
|---|---|
| User-agent: * | Група для всіх пошукових роботів |
| Disallow: /private/ | Не запитувати вказаний шлях |
| Allow: /private/public.css | Виняток для конкретного ресурсу |
| Sitemap: https://… | Адреса XML sitemap |
Не плутайте crawling, indexing і доступ користувача
robots.txt не є засобом авторизації. Приватні дані потрібно захищати входом або серверними правилами. Для публічної сторінки, яку не слід показувати в пошуку, застосовують meta robots або X-Robots-Tag noindex, дозволяючи пошуковому роботу прочитати директиву.
Після зміни правила перевірте не лише сам файл, а й сторінку. Вона має повертати очікуваний статус, а canonical та sitemap не повинні суперечити новій політиці.
CSS, JavaScript і зображення
Блокування службової папки може одночасно закрити CSS, JavaScript або зображення, потрібні для правильного відображення сторінки. Для сучасного сайту важливо, щоб Google міг завантажити ресурси основного шаблону.
Перевіряйте URL ресурсів окремо. Якщо вони публічні й потрібні сторінці, правило має дозволяти пошуковому роботу їх завантажувати. Водночас не потрібно відкривати приватні резервні копії, журнали або адміністративні адреси.
Коротка production-перевірка
Після deploy завантажте robots.txt як звичайний користувач і з User-Agent Googlebot. Потім перевірте кілька важливих URL: головну, статтю, сторінку послуги, CSS і sitemap.
На Montana WebStudio файл дозволяє crawling публічних сторінок і посилається на sitemap. ads.txt перевіряється окремо й не повинен бути закритий для пошукового робота AdSense.
- Перевірити HTTP та HTTPS.
- Зіставити групи й правила.
- Протестувати репрезентативні URL.
- Переконатися, що CSS/JS доступні.
- Перевірити директиву Sitemap після публікації.
Часті запитання
Чи можна закрити сторінку від Google через robots.txt?
Disallow блокує сканування, але URL іноді може залишатися відомим. Для виключення публічної HTML-сторінки використовують noindex, не блокуючи пошуковому роботу доступ до директиви.
Чи потрібно блокувати wp-admin?
Адміністративні шляхи зазвичай не потрібні пошуковому роботу, але безпека все одно має забезпечуватися авторизацією, а не лише robots.txt.
Де має бути файл?
У корені конкретного хоста, наприклад https://example.com/robots.txt. Файл у підпапці не керує всім сайтом.