Wykrywanie, przeszukiwanie i indeksowanie to osobne etapy
Google musi najpierw znaleźć adres URL za pomocą linku wewnętrznego, mapy witryny lub źródła zewnętrznego. Robot może następnie pobrać kod HTML. Dopiero po przetworzeniu Google decyduje, czy strona należy do indeksu i który adres URL należy traktować jako kanoniczny.
Dlatego „URL jest nieznany Google” różni się od „Przeszukane – obecnie nieindeksowane”. Pierwszy komunikat zwykle oznacza problem z wykryciem adresu. Drugi wskazuje, że Google odwiedził stronę, ale nie dodał jej do indeksu albo jeszcze nie zakończył przetwarzania.
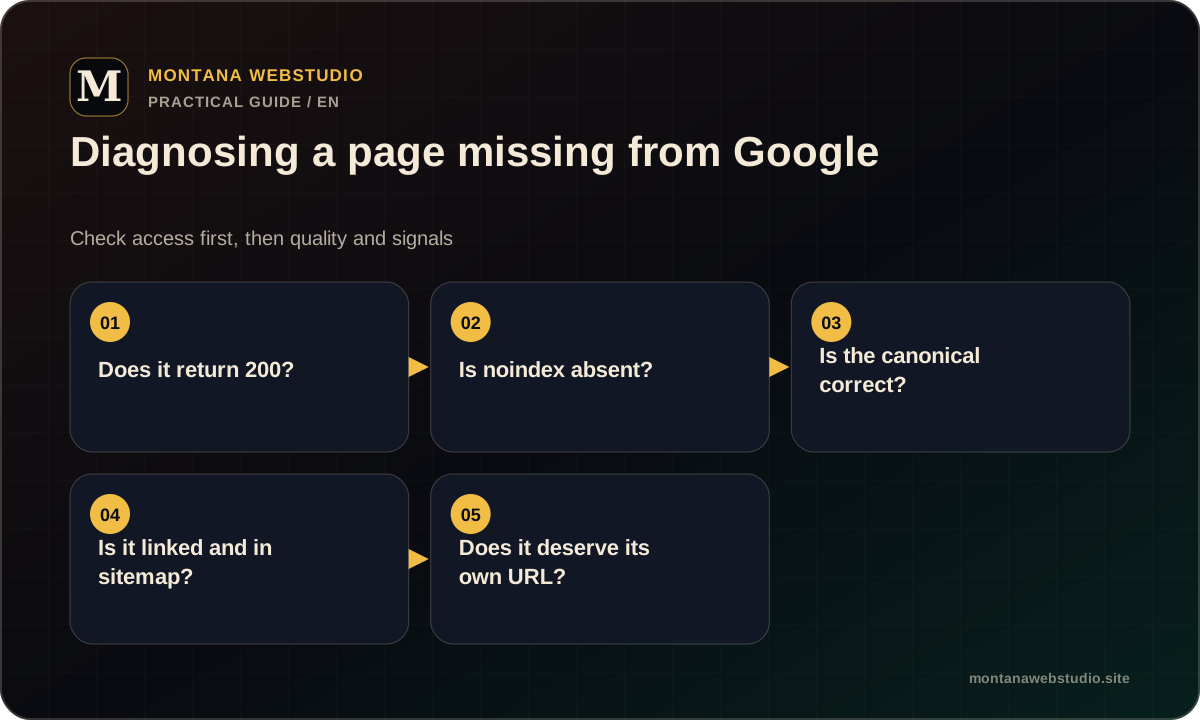
Sprawdź bloki techniczne
Otwórz adres URL bez logowania i potwierdź status HTTP. Strona przeznaczona do indeksowania nie powinna zwracać wartości 404, 5xx ani pętli przekierowań. Nagłówki HTML i HTTP nie powinny zawierać noindex.
Plik robots.txt musi zezwalać na odpowiednią ścieżkę. Gdy indeksowanie jest zablokowane, Google może znać adres URL, ale nie jest w stanie go odczytać. Sprawdź także, czy adres canonical nie wskazuje innej strony, ponieważ zduplikowany adres URL może zostać celowo wykluczony na rzecz innej strony.
- Odpowiedź 200 dla zamierzonej strony.
- Brak dyrektywy noindex w meta robots lub X-Robots-Tag: noindex.
- Robots.txt pozwala na stronę i wymagane zasoby.
- Link canonical wskazuje prawidłowy, preferowany adres URL.
- Treść podstawowa nie zależy od czynności, której Googlebot nie może wykonać.
Pomóż wyszukiwarkom odkryć stronę
Dodaj kanoniczny adres URL do mapy witryny XML i sprawdź, czy mapa witryny jest dostępna. Nie polegaj wyłącznie na tym: strona powinna otrzymać naturalne linki wewnętrzne z odpowiednich sekcji. Strona, do której nie prowadzą żadne linki, jest odizolowana zarówno dla robotów, jak i użytkowników.
Użyj tekstu linku wyjaśniającego miejsce docelowe. „Techniczna lista kontrolna SEO” zawiera więcej kontekstu niż „dowiedz się więcej”, jeśli jest to artykuł, który otworzy odwiedzający.
Oceń wyjątkowość i użyteczność
Dostęp techniczny nie gwarantuje indeksowania. Strona, która powtarza inny adres URL, zawiera tylko ogólne akapity, jest ubogą stroną filtrowania lub istnieje wyłącznie dla odmiany słowa kluczowego, może nie uzasadniać osobnego wyniku.
Porównaj to z zaindeksowanymi stronami w tej samej witrynie. Powinna odpowiadać na konkretną potrzebę, mieć jasny H1, wystarczający kontekst, użyteczną strukturę lub przykłady oraz logiczne miejsce w architekturze serwisu. Konsolidacja słabych duplikatów jest często lepsza niż próba indeksowania ich wszystkich.
Jak sprawdzić adres URL w Search Console
Kontrola adresów URL pokazuje, czy Google zna adres, czy dozwolone jest indeksowanie, zadeklarowany adres kanoniczny i kanoniczny wybrany przez Google. Po naprawieniu przetestuj aktywny adres URL przed zażądaniem indeksowania strony priorytetowej.
Nie przesyłaj codziennie tego samego niezmienionego adresu URL. Powtarzające się żądanie nie usuwa podstawowego problemu. Nowe strony internetowe mogą charakteryzować się normalnym opóźnieniem pomiędzy publikacją, indeksowaniem i pojawieniem się w wynikach. Skorzystaj z pełnej technicznej listy kontrolnej SEO przed publikacją, aby sprawdzić wszystkie powiązane sygnały.
| Status | Co oznacza | Pierwsze działanie |
|---|---|---|
| Adres URL jest nieznany Google | Adres nie został odnaleziony | Dodaj link wewnętrzny i wpis w mapie witryny |
| Zablokowany przez plik robots.txt | Crawlowanie jest zablokowane | Przejrzyj regułę wpływającą na ścieżkę |
| Strona alternatywna z prawidłowym tagiem canonical | Preferowany jest inny adres URL | Przejrzyj duplikaty i sygnały canonical |
| Zeskanowano – obecnie niezindeksowana | Google zeskanował stronę, ale jeszcze jej nie zindeksował | Oceń wartość, powielanie i kontekst |
| Adres URL znajduje się w Google | Strona jest zaindeksowana | Monitoruj wyświetlenia i zapytania |
Często zadawane pytania
Ile czasu zajmuje Google indeksowanie nowej strony?
Nie ma ustalonego czasu. Wykrywanie i przetwarzanie może trwać dłużej w przypadku nowej lub rzadko aktualizowanej strony internetowej niż w przypadku witryny często przeszukiwanej.
Czy muszę przesyłać każdą stronę ręcznie?
Nie. Silne linki wewnętrzne i mapa witryny XML umożliwiają automatyczne wykrywanie. Ręczna inspekcja jest przydatna w przypadku priorytetowych adresów URL i diagnostyki.